Facundo Uferer
Colecciones en Java y Genéricos (JCF)
En las próximas lecciones vas a implementar listas, pilas y colas a mano, para entender exactamente cómo funcionan por dentro. Antes de llegar ahí, la buena noticia: en el día a día no hace falta escribir nada de esto. Java lo trae todo, optimizado durante treinta años y probado por millones de aplicaciones.
Pero fijate lo que ganaste: cuando alguien te diga “usá un HashMap”, vas a saber que por dentro hay un arreglo y un mecanismo de colisiones. Cuando veas LinkedList, vas a saber por qué acceder al elemento 500 es lento. Esa es la diferencia entre usar una herramienta y entenderla.
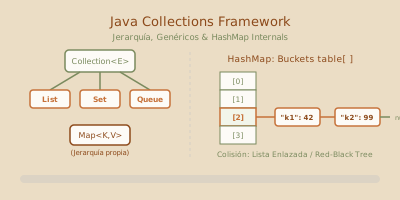
1. La jerarquía del Java Collections Framework
Esa última frase es una regla concreta, no un consejo:
// Bien: el tipo de la variable es la interfaz
List<String> nombres = new ArrayList<>();
Map<String, Integer> stock = new HashMap<>();

// Mal: te atás a la implementación
ArrayList<String> nombres = new ArrayList<>();
Con la primera forma, cambiar a LinkedList es tocar una palabra. Con la segunda, si alguien usó un método propio de ArrayList, es tocar todo. Es el mismo principio que vas a formalizar más adelante como TAD (Tipo Abstracto de Dato) —programar contra la especificación, no contra la implementación— aplicado acá a la biblioteca estándar.
2. Genéricos: el problema que vinieron a resolver
Antes de Java 5 las colecciones guardaban Object. Todo compilaba, y los errores aparecían cuando el programa ya estaba en producción.
Con genéricos, además, el compilador ya sabe qué sale de la colección y el casteo desaparece:
List<String> nombres = new ArrayList<>();
nombres.add("Laura");
String primero = nombres.get(0);   // sin casteo: el compilador sabe que es String
El <> vacío de la derecha se llama diamante y le dice al compilador “el mismo tipo que declaré a la izquierda”. Escribir new ArrayList<String>() no está mal, es redundante.
3. Las cuatro familias, y cuándo usar cada una
List — orden de inserción, duplicados permitidos
List<String> tareas = new ArrayList<>();
tareas.add("Estudiar POO");
tareas.add("Practicar listas");
tareas.add("Estudiar POO");        // se repite, y está bien

System.out.println(tareas.get(1));      // acceso por índice
System.out.println(tareas.size());      // 3
Set — sin duplicados, y el orden depende de la implementación
Set<String> etiquetas = new HashSet<>();
etiquetas.add("java");
etiquetas.add("poo");
etiquetas.add("java");              // ignorado, ya estaba

System.out.println(etiquetas.size());   // 2
HashSet no garantiza ningún orden. LinkedHashSet conserva el orden de inserción. TreeSet mantiene los elementos ordenados y te da operaciones como first(), last() y headSet().
Cuidado: para que un HashSet detecte duplicados de tus propias clases, esas clases tienen que implementar equals() y hashCode() correctamente. Sin eso, dos objetos idénticos entran los dos. Es el tema central de la próxima lección.
Map — asociar una clave a un valor
Es la colección más usada de todas, y la que más se subutiliza:
Map<String, Integer> stock = new HashMap<>();
stock.put("yerba", 12);
stock.put("café", 5);
stock.put("yerba", 20);            // sobrescribe: las claves son únicas

System.out.println(stock.get("yerba"));           // 20
System.out.println(stock.get("azúcar"));          // null — no está
System.out.println(stock.getOrDefault("azúcar", 0));  // 0 — mucho mejor

// Recorrer un Map:
for (Map.Entry<String, Integer> entrada : stock.entrySet()) {
    System.out.println(entrada.getKey() + " → " + entrada.getValue());
}
Los métodos modernos de Map eliminan casi todos los if que se solían escribir a mano:
// En lugar de: if (!mapa.containsKey(k)) mapa.put(k, new ArrayList<>());
mapa.computeIfAbsent(clave, k -> new ArrayList<>()).add(valor);

// En lugar de: contador.put(p, contador.containsKey(p) ? contador.get(p) + 1 : 1);
contador.merge(palabra, 1, Integer::sum);

// En lugar de: if (mapa.get(k) == null) mapa.put(k, v);
mapa.putIfAbsent(clave, valor);
Queue / Deque — orden de procesamiento
Los vas a implementar a mano más adelante, en TAD Pila y TAD Cola, pero ya podés usarlos hoy: ArrayDeque para pila y cola; PriorityQueue cuando el próximo a salir no es el que llegó primero, sino el de mayor prioridad.
4. Cómo funciona un HashMap por dentro
Esto explica de una vez por qué get() es O(1) y por qué equals/hashCode importan tanto.
get() es una cuenta. Con hash malo, todo cae en un bucket y el mapa degenera en una lista: O(n).Esa última frase del pie es el motivo por el que la próxima lección existe. Un hashCode() mal implementado no rompe la compilación ni lanza ninguna excepción: solo hace que tu HashMap sea cien veces más lento, o que directamente no encuentre lo que guardaste.
5. Escribir tus propios genéricos
No son solo para usar; también podés escribirlos. Una clase genérica declara sus parámetros de tipo entre <>:
public class Caja<T> {
    private T contenido;

    public void guardar(T contenido) { this.contenido = contenido; }
    public T sacar() { return contenido; }
}

Caja<String> cajaTexto = new Caja<>();
cajaTexto.guardar("hola");
String s = cajaTexto.sacar();   // sin casteo
Un método genérico declara su propio parámetro de tipo antes del retorno:
public static <T> T primero(List<T> lista) {
    if (lista.isEmpty()) throw new NoSuchElementException("Lista vacía");
    return lista.get(0);
}
Y podés acotar el tipo con extends, para poder usar métodos del tipo acotado:
// T tiene que ser comparable, así podemos usar compareTo
public static <T extends Comparable<T>> T maximo(List<T> lista) {
    T mayor = lista.get(0);
    for (T elemento : lista) {
        if (elemento.compareTo(mayor) > 0) mayor = elemento;
    }
    return mayor;
}
Por convención los parámetros de tipo son una sola letra mayúscula: T (type), E (element), K y V (key, value), R (result).
Type erasure: la letra chica
Los genéricos existen solo en tiempo de compilación. La JVM no sabe nada de ellos: en el bytecode, List<String> y List<Integer> son la misma cosa. Se llama borrado de tipos, y explica limitaciones que de otra forma parecen arbitrarias:
List<String> a = new ArrayList<>();
List<Integer> b = new ArrayList<>();
System.out.println(a.getClass() == b.getClass());   // true — son la misma clase

// T[] arreglo = new T[10];   // no se puede: en ejecución no se sabe qué es T
6. Cuál elegir
| Necesito… | Uso |
|---|---|
| Orden de inserción y acceso por índice | ArrayList |
| Insertar y borrar mucho en los extremos | ArrayDeque |
| Elementos únicos, sin importar el orden | HashSet |
| Elementos únicos, siempre ordenados | TreeSet |
| Clave → valor, acceso rapidísimo | HashMap |
| Clave → valor, recorrido en orden de clave | TreeMap |
| Clave → valor, en orden de inserción | LinkedHashMap |
| Sacar siempre el de mayor prioridad | PriorityQueue |
7. Errores frecuentes
| Error | Qué pasa | Cómo se arregla |
|---|---|---|
Declarar ArrayList<T> x = new ArrayList<>() | Te atás a la implementación y cambiarla obliga a tocar todo el código que la usa. | Declarar con la interfaz: List<T> x = new ArrayList<>(). |
Usar objetos propios en HashSet/HashMap sin equals/hashCode | Se guardan duplicados y get() devuelve null con la clave correcta. | Implementar ambos métodos de forma coherente (Iteradores, Ordenamiento y Contrato equals/hashCode). |
| Modificar una colección mientras se la recorre con for-each | ConcurrentModificationException. | Iterator.remove() o removeIf() (Iteradores, Ordenamiento y Contrato equals/hashCode). |
mapa.get(k) sin contemplar null | NullPointerException al desempaquetar un Integer que vino en null. | getOrDefault(k, valorPorDefecto). |
Usar LinkedList “porque insertar es más rápido” | En la práctica es más lenta que ArrayList por los fallos de caché. | ArrayList salvo que midas y demuestres lo contrario. |
Usar clave mutable en un HashMap | Si el objeto cambia, su hashCode cambia y queda perdido en el bucket viejo. | Claves inmutables: String, Integer, o clases con campos final. |
Intentar modificar una lista de List.of(...) | UnsupportedOperationException: es inmutable. | new ArrayList<>(List.of(...)) si necesitás modificarla. |
8. Ejercicio práctico guiado
Desafío: contador de frecuencias de palabras
Escribí un programa que reciba un texto y muestre cuántas veces aparece cada palabra.
- Normalizá el texto: todo a minúsculas, sin signos de puntuación.
- Contá las frecuencias con un
Map<String, Integer>. - Mostrá el resultado ordenado por frecuencia descendente y, a igual frecuencia, alfabéticamente.
- Mostrá también cuántas palabras distintas hay, usando un
Set. - Ignorá palabras vacías de significado (
de,la,el,y,que…).
Ver solución sugerida
import java.util.*;

public class ContadorDePalabras {

    private static final Set<String> VACIAS = Set.of(
        "de", "la", "el", "y", "que", "en", "a", "los", "las", "un", "una", "es"
    );

    public static Map<String, Integer> contar(String texto) {
        Map<String, Integer> frecuencias = new HashMap<>();

        // \\p{L}+ toma secuencias de letras, incluidas las acentuadas
        for (String palabra : texto.toLowerCase().split("[^\\p{L}]+")) {
            if (palabra.isBlank() || VACIAS.contains(palabra)) {
                continue;
            }
            // merge: si no está, guarda 1; si está, aplica Integer::sum
            frecuencias.merge(palabra, 1, Integer::sum);
        }
        return frecuencias;
    }

    public static void main(String[] args) {
        String texto = """
            La programación orientada a objetos organiza el software en objetos.
            Cada objeto combina estado y comportamiento, y el estado de un objeto
            se protege con encapsulamiento. La herencia y el polimorfismo permiten
            que el software crezca sin reescribir el software existente.
            """;

        Map<String, Integer> frecuencias = contar(texto);

        // Un Set nos da las palabras distintas sin escribir una sola línea de lógica
        Set<String> distintas = frecuencias.keySet();
        System.out.println("Palabras distintas (sin contar vacías): " + distintas.size());
        System.out.println("Total de apariciones: " +
            frecuencias.values().stream().mapToInt(Integer::intValue).sum());
        System.out.println();

        // Ordenamos: primero por frecuencia descendente, después alfabéticamente
        List<Map.Entry<String, Integer>> ordenadas = new ArrayList<>(frecuencias.entrySet());
        ordenadas.sort(
            Map.Entry.<String, Integer>comparingByValue().reversed()
                .thenComparing(Map.Entry.comparingByKey())
        );

        System.out.println("Top 8:");
        for (Map.Entry<String, Integer> e : ordenadas.subList(0, Math.min(8, ordenadas.size()))) {
            System.out.printf("  %-16s %s%n", e.getKey(), "▮".repeat(e.getValue()) + " " + e.getValue());
        }

        // Bonus: agrupar palabras por su longitud, con computeIfAbsent
        Map<Integer, List<String>> porLongitud = new TreeMap<>();
        for (String palabra : distintas) {
            porLongitud.computeIfAbsent(palabra.length(), k -> new ArrayList<>()).add(palabra);
        }
        System.out.println("\nPalabras de 10 letras: " + porLongitud.getOrDefault(10, List.of()));
    }
}
Tres cosas para mirar acá.
frecuencias.merge(palabra, 1, Integer::sum) reemplaza al clásico if (mapa.containsKey(p)) mapa.put(p, mapa.get(p) + 1); else mapa.put(p, 1);. Una línea en lugar de cuatro, y sin posibilidad de equivocarse en el caso de la primera aparición.
porLongitud.computeIfAbsent(len, k -> new ArrayList<>()).add(palabra) es el patrón para armar un mapa de listas. Sin él tendrías que chequear si la lista existe antes de agregar, en cada iteración.
Y VACIAS es un Set, no una List, porque lo único que hacemos con él es preguntar contains. En un Set eso es O(1); en una List sería O(n) y se ejecuta una vez por palabra del texto. Elegir la colección correcta es una decisión de rendimiento, no de estilo.
Para llevarte
- El JCF separa interfaces (el TAD) de implementaciones. Declará siempre con la interfaz.
Mapno extiendeCollection: guarda asociaciones, no elementos sueltos.- Los genéricos no aceleran nada: adelantan el error de la producción al momento de escribir la línea.
- El borrado de tipos hace que los genéricos no existan en ejecución. De ahí vienen sus limitaciones.
- En un
HashMap,hashCode()elige el bucket yequals()elige el elemento dentro del bucket. - Un
hashCode()mal hecho no lanza ninguna excepción: solo hace que no encuentres lo que guardaste. merge,computeIfAbsent,getOrDefaultyputIfAbsenteliminan la mayoría de losifalrededor de un mapa.- Elegir la colección correcta es una decisión de rendimiento:
containssobre unSetes O(1); sobre unaList, O(n).